基于学习的点云定位技术 网络技术的研究与进展
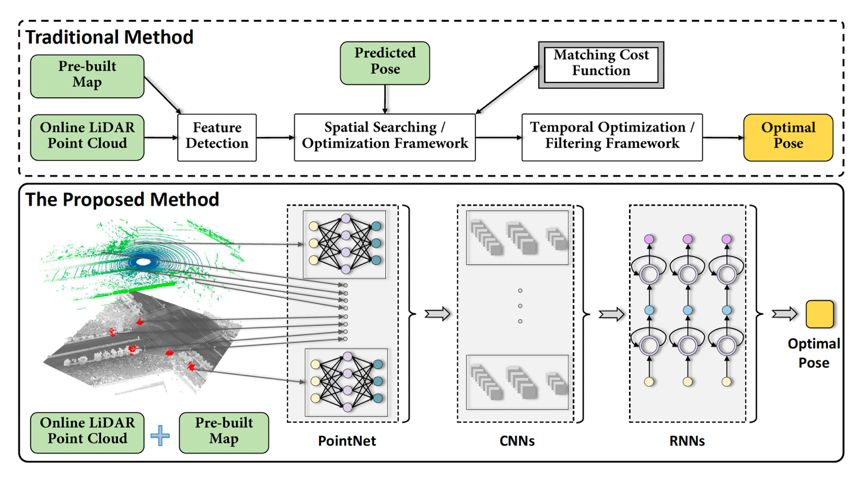
随着自动驾驶、机器人导航和增强现实等领域的快速发展,高精度、鲁棒的定位技术成为关键需求。传统的定位方法依赖GPS、惯性测量单元或激光雷达的几何匹配,但在复杂环境中(如隧道、城市峡谷、室内场景)往往性能下降。基于深度学习的点云定位技术凭借其强大的特征提取能力和对环境变化的适应性,成为研究热点。本文系统梳理了基于学习的点云定位技术中网络技术的研究进展,分析了主流网络架构、关键技术及未来挑战。
一、点云定位技术概述
点云是三维空间中离散点的集合,通常由激光雷达或深度相机获取。点云定位旨在通过点云数据估计传感器或移动平台的位姿(位置和姿态)。传统方法如ICP(迭代最近点)及其变体依赖几何配准,但对初始位姿敏感且易陷入局部最优。基于学习的方法则通过神经网络直接学习从点云到位姿的映射,或学习用于配准的局部特征描述子,从而提升定位的鲁棒性和泛化能力。
二、基于学习的点云定位网络架构
1. 基于体素(Voxel)的网络
将点云划分为规则的3D体素网格,然后利用3D卷积神经网络(3D CNN)提取特征。代表工作如VoxelNet、PointPillars等,通过体素化将无序点云转换为有序结构,便于卷积操作。体素方法能有效捕捉局部几何信息,但体素分辨率与计算开销之间存在权衡,且量化过程会损失细粒度信息。
2. 基于点(Point-based)的网络
直接处理原始点云,无需体素化。PointNet及其改进版PointNet++通过对称函数和分层特征学习,解决了点云的无序性和旋转不变性问题。此类网络在点云分类和分割中表现优异,也被扩展至定位任务。例如,PointNetLK将PointNet与Lucas-Kanade算法结合,迭代估计位姿。基于点的网络能保留原始几何细节,但计算复杂度随点数增加而显著增长。
3. 基于图(Graph)的网络
将点云中的点视为图节点,通过边连接邻域点,利用图神经网络(GNN)进行特征传播。GraphNet、DGCNN等通过动态图卷积捕捉点之间的拓扑关系,适用于非结构化点云。图网络在捕捉长距离依赖和局部结构方面具有优势,但图构建和消息传递的计算效率仍需优化。
4. 基于注意力(Attention)的网络
Transformer架构因其强大的全局建模能力被引入点云领域。Point Transformer、PCT等通过自注意力机制聚合点云特征,实现高效的点云表示学习。注意力机制能自适应地关注重要点,提升定位精度,但计算和内存开销较大,尤其在密集点云场景中。
三、关键技术研究
1. 特征描述子学习
基于学习的点云定位常通过提取局部特征描述子进行匹配。例如,3DMatch、PPFNet、FCGF等利用孪生网络或对比学习,训练网络生成对视角、噪声和遮挡鲁棒的描述子。这些描述子用于点云配准,结合RANSAC等算法估计位姿。
2. 端到端位姿回归
直接设计网络回归位姿参数。例如,PoseNet用于RGB图像,而PointNet-based回归网络则输入点云输出位姿。端到端方法避免了复杂的特征匹配步骤,但对网络容量和训练数据要求较高。
3. 迭代 refinements
结合迭代最近点(ICP)的思想,网络预测初始变换,然后迭代优化。如DeepICP、DCP等通过可微分的SVD或加权SVD层,使网络端到端可训练。迭代方法能提高精度,但可能陷入局部最优。
4. 多模态融合
融合点云与图像、IMU等数据,利用跨模态信息增强定位鲁棒性。例如,激光雷达-视觉-惯性里程计(LVI-SAM)通过网络融合多传感器特征。多模态方法能互补优势,但需解决时间同步和标定问题。
四、挑战与未来方向
当前基于学习的点云定位技术仍面临若干挑战:1)泛化能力:模型在训练集外的场景中性能下降,需领域自适应或元学习;2)计算效率:实时性要求高的场景下,网络需轻量化;3)标注数据:获取精确位姿标签成本高,需自监督或弱监督学习;4)动态环境:移动物体和季节变化影响定位,需动态感知与剔除。
未来研究方向包括:1)融合Transformer与几何先验,提升全局建模能力;2)开发高效的三维稀疏卷积和注意力机制;3)利用神经辐射场(NeRF)等隐式表示辅助定位;4)探索终身学习与增量学习,使系统持续适应新环境。
基于学习的点云定位技术通过深度网络自动学习点云特征与位姿映射,显著提升了定位的精度和鲁棒性。从体素、点、图到注意力网络,各种架构不断演进,推动着该领域的发展。尽管仍存在挑战,但随着算法创新与硬件进步,基于学习的点云定位有望在自动驾驶、机器人等领域实现大规模应用。
如若转载,请注明出处:http://www.gszwfwzx.com/product/9.html
更新时间:2026-10-24 07:41:39